
生成AIの問題点は、ハルシネーションなど技術から生まれるものと、情報漏洩や検証不足など運用から生まれるものに分かれます。2026年の公的データで全体像を整理し、導入後に表れる課題と業務フローのどこで防ぐかまで実務目線で解説します。
社内で生成AIを使い始めたものの、情報が漏れないか、誤った内容が混ざらないかが気になり、任せる範囲を広げられない。使ってはいるが、効率化になっているのかも説明できない。こうした困りごとの裏にあるのが、生成AIの問題点です。
一覧で知るだけでは業務は変わりません。どの工程で誰が何を決め、何を確かめ、何で測るかまで書き出して、はじめて問題点が減ります。
本記事では、生成AIの問題点を技術面と運用面に分けて整理し、2026年時点の公的データと民間調査、当社自身の運用をもとに、業務フローのどこで防ぐかまで解説します。
- 生成AIの問題点は、ハルシネーションなど技術から生まれるものと、情報漏洩や検証の欠落など運用から生まれるものに分かれます
- 企業が挙げる懸念のリストは、成果の側の課題をほとんど拾っていません。効果を説明できない、効く業務が偏る、全社に広がらない、出力がばらつく、の4つです
- 日本企業の対策はガイドラインの整備に偏り、企画段階の審査と導入後の検証が他国より薄いという公的データがあります。対策は誰が何を決め、確かめ、測るかまで書いて工程に固定すると、運用の中で潰せます
生成AIの問題点は技術面と運用面に分かれる
分ける軸は2つあります。1つは問題の出どころで、まずこちらから見ます。技術そのものから生まれる問題と、使い方や社内の体制から生まれる問題では、打ち手が変わります。技術側は完全には消せないため、出てきたものを後から見つけるほかありません。運用側は、入力してよい情報の線引きも参照させるデータの範囲も設定と手順で先に固定できるため、起きる前に止められます。「気をつける」でひとまとめにすると、どちらの手も打てません。
| 分類 | 主な問題点 | 打ち手の方向 |
|---|---|---|
| 技術から生まれる | ハルシネーション、過剰な同調、バイアス | 消せないので、出た後に見つける |
| 運用から生まれる | 機密情報の入力、権限設計の甘さ、確認の担当と順番の欠落 | 起きる前に止める |
著作権はこの2つにまたがるため、表から外して5章で扱います。生成物が既存の著作物に似ること自体は技術側の性質で出た後にしか見つけられず、公開する前に確かめる工程を置くところが運用側です。
もう1つの軸は何に困るかです。リスクとして困るものと、成果が出ないことで困るものに分かれます。上の表はリスクの側で、打ち手は見つけるか止めるかのどちらかです。成果の側は、出どころで言えば多くが運用にあたりますが、打ち手は測る・型を作る・判断基準を残すに変わります。こちらはもうひとつの柱として6章で扱います。
なお、問題点があること自体は使わない理由になりません。総務省と経済産業省のAI事業者ガイドライン(1-1で扱います)自身がこう書いています。
リスクの存在を理由として直ちにAIの開発・提供・利用を妨げるものではない
すでに使っている読者の判断は、使うかどうかではなく、任せる範囲をどこまで広げるかです。本記事も使いながら潰す前提で進みます。
技術から生まれる問題点
技術から生まれる問題点のうち、業務でとくに困るのはハルシネーションです。2024年4月に総務省と経済産業省が策定した「AI事業者ガイドライン(第1.0版)」は、従来からあるAIのリスクとは別に、生成AIで新たに表れたリスクの例として次の4つを挙げています。
- ハルシネーション:事実に基づかない内容をもっともらしく生成する
- 入力情報の流出:個人情報や機密情報がプロンプトから入り、出力を通じて外へ出る
- ディープフェイク:偽画像・偽動画が情報操作や世論工作に使われる
- バイアスの再生成:学習した情報に含まれる偏りが出力に再び現れ、使われるほど広がる
このうち入力情報の流出は運用側に入るため3章で扱い、ディープフェイクは社会全体のリスクのため本記事では踏み込みません。業務で向き合うのはハルシネーションとバイアス、それに4-2で扱う過剰な同調です。ガイドラインを社内ルールの下敷きにする使い方は7-6で扱います。
総務省の令和6年版 情報通信白書によると、ハルシネーションは技術的な対策が検討されているものの、完全には抑えられません。
参考生成AIが抱える課題|総務省 令和6年版 情報通信白書運用から生まれる問題点
運用から生まれる問題点は、AIの性能ではなく、決め事をどこに置くかで決まります。機密情報をそのまま貼る、参照させてよいデータの範囲を決めないまま社内文書をつなぐ、出てきた文章を誰も確認せずに公開する。上の表に挙げた3つは、いずれもAIの欠陥ではなく、業務フローに確認の場所と歯止めがないことが原因です。裏返せば、決め事と歯止めの場所を先に決めれば、その日から減らせます。ルールを1本書くだけでは足りない理由は7章で扱い、具体的な問題点と備えは3章から順に見ていきます。
データで見る生成AIの問題点の現在地
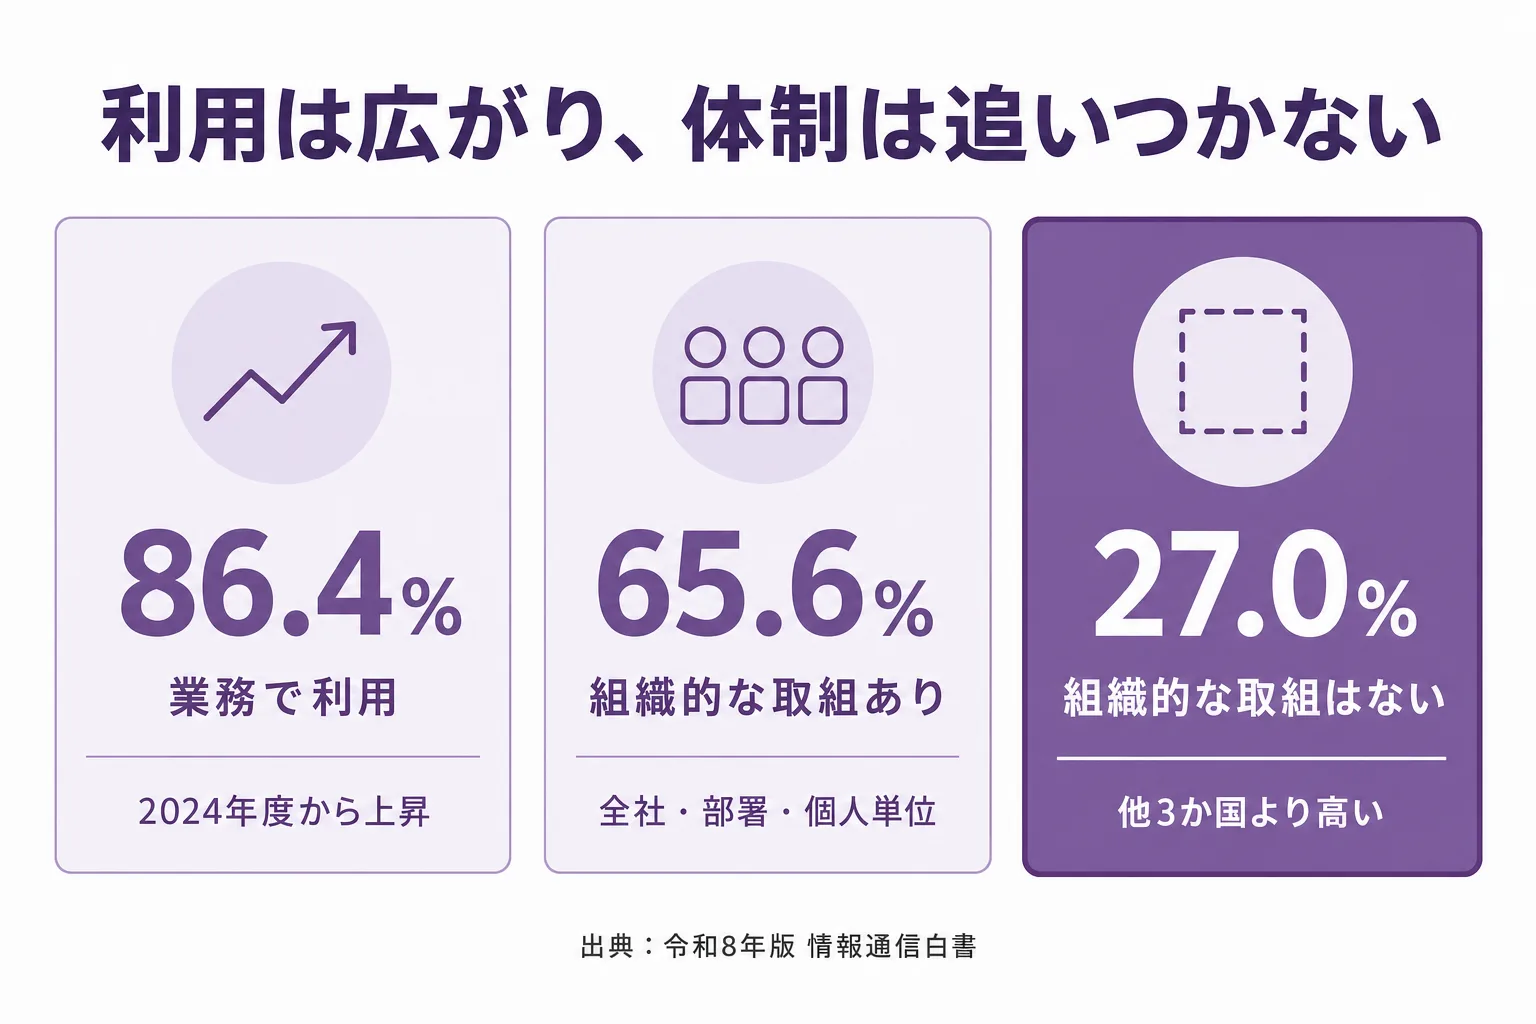
2026年の公的データを見ると、論点は「導入するかどうか」から「使いこなせるかどうか」へ移っています。ここでは令和8年版 情報通信白書とIPAの資料で現在地を確認します。
業務利用は86.4%、組織の決め事は追いつかない
日本企業の業務利用は、すでに例外的な取り組みではありません。何らかの業務で生成AIを利用している日本企業は86.4%で、2024年度調査の55.2%から31ポイント上がりました(活用方針を「わからない」と答えた企業を除いた集計)。ただし大企業を含む全体の数値で、中小企業の実態は6章で別の調査から見ます。
参考生成AIの業務利用状況|総務省 令和8年版 情報通信白書一方で同白書の「組織的な取組状況」では、「組織的な取組はない」が27.0%でした。米国1.4%・ドイツ4.9%・中国2.6%と比べて桁が違います。使う企業は増えた一方で、日本は4社に1社が組織としての決め事を持っていません。個人の判断に任せた範囲が広いほど、この記事で挙げる問題点は表に出やすくなります。
参考組織的な取組状況|総務省 令和8年版 情報通信白書日本企業が挙げる懸念の上位3つ
日本企業が挙げる懸念には、はっきりした順位があります。同白書の「懸念されるリスク及びリスク対策のための取組状況」によると、上位は次の3つです。
- 社内情報の漏洩などのセキュリティリスク(46.4%)
- 出力結果の精度(35.3%)
- 著作権等の権利侵害(31.3%)
本記事が3章に情報漏洩、4章に出力の精度、5章に著作権を置いたのは、この順に沿ったためです。社内で説明する場面でも、公的調査の順に沿うほうが納得を得やすくなります。ただしこのリストは活用にあたって懸念されるリスクを尋ねたもので、1章で分けた成果の側の課題は、ほとんど拾われていません。
セキュリティの脅威としても数えられた
生成AIのリスクは、情報セキュリティの主要テーマにも入りました。IPAの「情報セキュリティ10大脅威 2026」では、「AIの利用をめぐるサイバーリスク」が組織向けの3位に初めて選ばれています。想定される内容には、攻撃の容易化と並んで「AIが加工・生成した結果を十分に検証せず鵜呑みにすることにより生じる問題」が挙げられました。自社の使い方そのものが脅威に数えられたことになります。この問題を4章で扱います。
参考「情報セキュリティ10大脅威 2026」を決定|IPA(2026年1月29日)情報漏洩につながる生成AIの問題点と社内での備え
情報漏洩への備えは、3つの決め事に整理できます。会社としてどのサービスを用意するか、何を入力してよいか、AIに何を参照させるかです。3つとも、担当者が都度判断する形にせず会社として決めてください。
入力した情報の扱いはサービスと契約で決まる
入力した情報がAIの学習に使われるかどうかは、使うサービスと契約ごとに変わります。AIに共通の性質ではありません。法人向けサービスには、学習に使わないと明示しているものがあります。マイクロソフトは公式ドキュメントで、Microsoft Graph(Microsoft 365 内の文書やメール等にアクセスする仕組み)経由のプロンプト・応答・データを、基盤となる大規模言語モデルのトレーニングに使用しないと明記しています。
参考Microsoft Copilot のデータ、プライバシー、セキュリティ|Microsoft Learn一方、個人向けのプランでは有料であっても同じ扱いを前提にできません。使っているサービスの利用規約とプライバシーポリシーを開き、入力データの扱いを確認してください。
入力してよい情報を先に線引きする
個人情報を含むプロンプトを入力する場面では、確認すべきことが具体的に決まっています。個人情報保護委員会は2023年6月2日の注意喚起で、個人情報取扱事業者に次の2点を求めました。
- 個人情報を含むプロンプトを入力する場合は、特定された利用目的(自社のプライバシーポリシーに書いてあるもの)を達成するために必要な範囲内であることを十分に確認する
- 本人の同意なく個人データを含むプロンプトを入力する場合は、当該サービスの提供事業者がその個人データを機械学習に利用しないこと等を十分に確認する
2つ目の「個人データ」は、名簿や顧客管理システムのように検索できる形へ整理された個人情報を指します。
参考生成AIサービスの利用に関する注意喚起等|個人情報保護委員会(令和5年6月2日)個人情報以外の機密情報には、こうした公的な基準がありません。線引きは自社で決めます。判断の材料は、外に出たときに困る相手がいるか(取引先・従業員)と、まだ公表していないかの2つです。取引条件・見積・人事情報・未公表の企画は入れない、と具体名で並べてください。「機密情報は入れない」とだけ書いたルールは、現場で判断できません。
シャドーAIと社内の権限設計
1つ目と3つ目には、見落とされやすい穴があります。会社が知らないまま社員が個人の判断でAIを使う「シャドーAI」と、社内データの権限設計です。
総務省は令和8年版 情報通信白書で、シャドーAIに機密情報の流出などのリスクがあると指摘し、対策として情報漏洩対策を施した活用環境の社内整備とルールの周知を挙げています。禁止令だけを出すと、社員は個人アカウントに逃げます。
前述のマイクロソフトのドキュメントによると、Copilotが表示するのは個々のユーザーが表示アクセス許可を持つ組織データだけです。裏を返せば、社員がもともと見られるものはすべて参照します。探さなければ気づかなかった文書も、質問ひとつで表に出てきます。権限設定が緩いままの場合は、その緩さがそのまま漏洩の経路になります。触るのは社員の閲覧権限と、AIに参照させる範囲の両方です。令和8年版 情報通信白書によると、AI活用が進んだ企業は参照させるデータを部門や職階に応じて絞っています。
ハルシネーションと出力品質は人の確認を前提にする
外へ出した時点で、AIが書いたかどうかにかかわらず、受け取った相手からは企業が作ったものとして見られます。誤りが混ざったまま提案書や顧客への回答に載れば、訂正と信用回復の手間は自社が負います。この章では、事実の誤り・過剰な同調・偏りという出力の問題を整理します。確認を誰がどの工程で担うかは、7章で組み立てます。
完全には抑えられない前提で使う
ハルシネーションは起きる前提に立ち、見つける工程を置きます。前述のマイクロソフトのドキュメントには、生成AIの応答が100%事実である保証はないと書かれており、出力を他の人へ渡す前の確認は使う側の役割だと明記されています。
精度を上げる手当てとして、社内資料や信頼できる情報源を根拠に参照させるグラウンディングがあります。ただし技術を入れても、確認を人が担う前提は変わりません。
どの情報を根拠にさせるかは、使い始める前に決める部分です。下記記事で解説していますので、あわせてご覧ください。
事実の誤りだけでなく過剰な同調も起きる
出力の問題は、事実誤認にとどまりません。令和8年版 情報通信白書では、ハルシネーションと並べて、ユーザーに過剰に同調してしまう「シカファンシー(sycophancy)」が取り上げられ、偏見やバイアスにつながる出力のリスクにも触れられています。
この2つは、誤りだと気づきにくいのがやっかいです。自分の仮説をぶつけると根拠の薄い案でも肯定的な材料ばかり集まり、企画の壁打ちに使えば賛成意見だけの資料ができあがります。1章で挙げたバイアスは、人物像を含む指示で表に出ます。「若手向けの案内文」「主婦向けの提案」のように属性を指定すると、学習元に多い書かれ方がそのまま反映され、型にはまった表現が混じります。読む相手によっては決めつけと受け取られます。どちらも、観点を決めずに読んでいるかぎり気づけません。偏りは「特定の属性を決めつけていないか」、過剰な同調は「材料が一方に寄っていないか」で見ます。
指示の出し方である程度は減らせます(書き方は6-4の関連記事で扱います)。それでも偏りは残るため、1章の表のとおり技術から生まれる問題として、出た後に見つけるほかありません。この2つの確認を、事実の裏取りと同じ工程に並べて置いてください。
著作権と権利侵害を避けるための実務対応
著作権の問題は、法律の解釈に踏み込む前に、社内で決めておく手順で大きく減らせます。文化庁が公開している事業者向けのチェックリストが、そのまま実務の手順になります。
使う前に既存の著作物と似ていないか確かめる
著作権の判断は、生成した時点と、その生成物を使う時点で分かれます。文化庁のチェックリストは、生成の段階と利用の段階で見るところが変わると整理しています。生成の段階で見るのは、既存の著作物を入力したかどうかなど生成の過程です(5-2)。確認が厳しくなるのは使う段階です。社外に出す資料はもちろん、社内で回すだけの資料も対象になります。
参考AIと著作権に関するチェックリスト&ガイダンス|文化庁著作権課(令和6年7月31日)侵害の成立には、既存の著作物との「類似性」と「依拠性」(既存の著作物を参照して作られたといえるか)の両方が必要です。使う前にまず確かめるのは類似性のほうで、インターネット検索から始めます。文章は特徴的なフレーズをそのまま検索し、画像は画像検索にかけます。この2つを使う前のチェック項目に加えるだけで、明らかな類似は拾えます。ただし検索窓に入れた文字列も、画像検索に上げた画像も、検索事業者に残ります。未発表の情報が含まれる場合は、社名や商品名を伏せた部分だけを検索し、公表後に全体をあらためて確認してください。
生成の経緯を残し、規約と段取りを先に決める
使ったプロンプトなど生成の経緯を確認できる形にしておくと、依拠性がなかったことをあとから説明する材料になります。まず、既存の著作物そのものや、題号・キャラクター名などの固有名詞は入力しないでください。そのうえでプロンプトと生成日時を成果物と一緒に保存する運用にしてください。
予防はサービス選びの段階から始まります。3-1で確認した利用規約には、他人の著作物の入力禁止など、著作権侵害のおそれがある利用方法を制限しているものもあります。
文化庁は、社内ルールなどの予防措置と、万一侵害が起きたときの対応を先に想定しておくことも望ましいとしています。挙げられている対応の例は、情報共有・サービスの停止と復旧・権利者への対応・原因解明・再発防止措置の5つです。提供する側の項目も含みますが、大半は使う立場でも自社で動く部分です。誰が動くかとセットで社内ルールに書いておくと、初動が遅れません。
成果の側に表れる生成AIの問題点
ここからは、成果の側の問題点へ視点を移します。使い始めた企業がつまずくのは、2章で見た懸念のリストではほとんど拾われない次の4点です。
- 効果があったのかを説明できない
- 効果が出る業務と、効果を出せる企業に偏りがある
- 一部の社員しか使わず全社に広がらない
- 出力の質が人によってばらつく
順に見ていきます。
効果があったのかを説明できない
導入後は、まず効果の説明でつまずきます。PwC Japanグループが2026年2月に実施した6カ国比較のWeb調査では、日本の回答者932名のうち87%(814名)が生成AIを活用中・推進中と答えました。それでも回答者932名全体で見ると、効果が「期待を大きく上回っている」は9%にとどまります(米国は38%)。
効果の発現状況は、活用中・推進中と答えた層について5段階で示されています。日本の値はいずれも回答者932名を母数にした割合で、「まだ効果を評価できていない」は13%、米国は0%でした。使っていない企業ではなく、使っているのに効果を測れていない層の割合です。効果を財務的な還元(売上やコストの数字に表れる形)まで結びつけた回答は、日本27%・米国61%でした。
参考生成AIに関する実態調査2026 春 6カ国比較|PwC Japanグループ同調査は、価値・品質・リスクの判断軸が曖昧なまま実装に進むため効果を説明できなくなる、と整理しています。回答者は売上高500億円以上の企業の課長職以上で中小企業の実態をそのまま表しませんが、測る基準を決めないまま使い始める構造は規模を問いません。
測る基準は凝ったものでなくてかまいません。対象の業務を1つ選び、かかっている時間・差し戻しの回数・月あたりの処理件数のうち1つを控えておいてください。すでに使っている業務は、いまの値を起点にすれば以降の変化を説明できます。さかのぼって効果を出すことはできないため、次に広げる業務では広げる前に一度測っておきましょう。
効果が出る業務と、効果を出せる企業に偏りがある
生成AIは、全社に一律で入れても効く場所が限られます。前掲の「生成AIの業務利用状況」(令和8年版 情報通信白書)では、日本は「議事録・メール作成補助」の活用が約7割で最も高く、同じ類型で効果を実感した割合も約7割で、白書は他の類型に比べて顕著に高いと評しています。
中小企業でも、入る場所は同じように偏ります。中小企業基盤整備機構が全国の中小企業10,000社に行った調査(有効回答1,668社)では、導入済み企業の業務分野別の導入率が総務・管理部門68.3%に対して製造・生産部門34.9%でした(使っているAIサービスは生成AIが82.6%で最多)。効果を測った数字ではありませんが、使われる場所が事務系に寄る点は白書と重なります。
参考中小企業のAI等の利活用に係る実態調査(2026年3月)|中小企業基盤整備機構効く場所が業務で偏るのに加えて、企業側の準備でも差がつきます。効果が出ている企業と出ていない企業の違いを、前掲のPwC調査から見てみましょう。
| 比べる軸 | 効果が期待未満の企業 | 効果が期待を大きく上回る企業 |
|---|---|---|
| 業務プロセス | ブラックボックスのまま | 可視化されている |
| データ | AI向けに整備されていない | 活用しやすい形に整備されている |
| リスクの扱い | 分析が不十分で挑戦を避けがち | 分析・評価に基づいて活用を広げている |
効果が出ている企業ほど、業務を選ぶ前の準備ができています。業務の手順を書き出してから、どこをAIに渡せるかを見極めてください。データは業務で使う資料をAIが読める形にそろえるところから、リスクは可否を判断する軸を決めるところから(7-2)着手できます。
自社と近い業種の着手事例は、下記記事で解説していますので、あわせてご覧ください。
一部の社員しか使わず全社に広がらない
環境を用意しても、使う人は自然には増えません。令和8年版 情報通信白書では、汎用的なAIツールを導入しても一部の積極的な社員が活用するにとどまり、全社的な効果につながらない可能性が指摘されています。
中小企業でも、全社の仕組みになっている例はごくわずかです。前掲の中小企業基盤整備機構の調査では、AIを導入している中小企業は全体の20.4%で、内訳は「全社的に導入している」3.6%、「一部の業務で導入している」16.8%でした(AI全般の導入率のため、2-1の86.4%とは母数も対象も違います)。導入した企業の8割強が一部の業務にとどまっている計算です。ここで数えているのは業務の広がりで、人の広がりは前段の白書の指摘が受け持ちます。
白書には、浸透に成功した企業として日清食品グループの取り組みが載っています。対象業務を部門ごとに選び、プロンプトのひな形を作り、効果を測定しながら社内展開した結果、生成AI利用率は白書の公表時点で7割超に達しました。環境を用意して終わりにせず、使いどころと効果を実感できる促進策まで行った点が浸透の要因とされています。
参考AI導入・活用による効果創出のステップ|総務省 令和8年版 情報通信白書大企業の例ですが、対象業務を絞り、ひな形を作り、効果を測るという順番そのものは人数に左右されません。部門が分かれていなくても、1つの業務で型を作ってから広げてください。
出力の質が人によってばらつく
同じツールを配っても、返ってくる成果物の質は担当者ごとに変わります。指示の出し方と、出てきた内容の直し方が人によって違うためです。うまくいっている人の判断基準は本人の頭の中にしかないことがほとんどで、コツを口頭で共有しても人が入れ替わると失われます。
前掲の「組織的な取組状況」(令和8年版 情報通信白書)に傍証があります。生成AI活用に必要なスキルやノウハウを学ぶ環境がある企業は日本39.9%で、米国62.7%・ドイツ60.4%・中国71.7%を大きく下回りました。学ぶ場が用意されていないほど、やり方は個人の工夫のままとどまります。ただし研修を1回開くだけでは、担当が変わると元に戻ります。
指示の書き方を個人の工夫で終わらせず、チームで揃える手順があります。下記記事で解説していますので、あわせてご覧ください。
判断基準を個人の中に置いたままにしない手当ては、7-5で扱います。
生成AIの問題点を業務フローのどこで潰すか
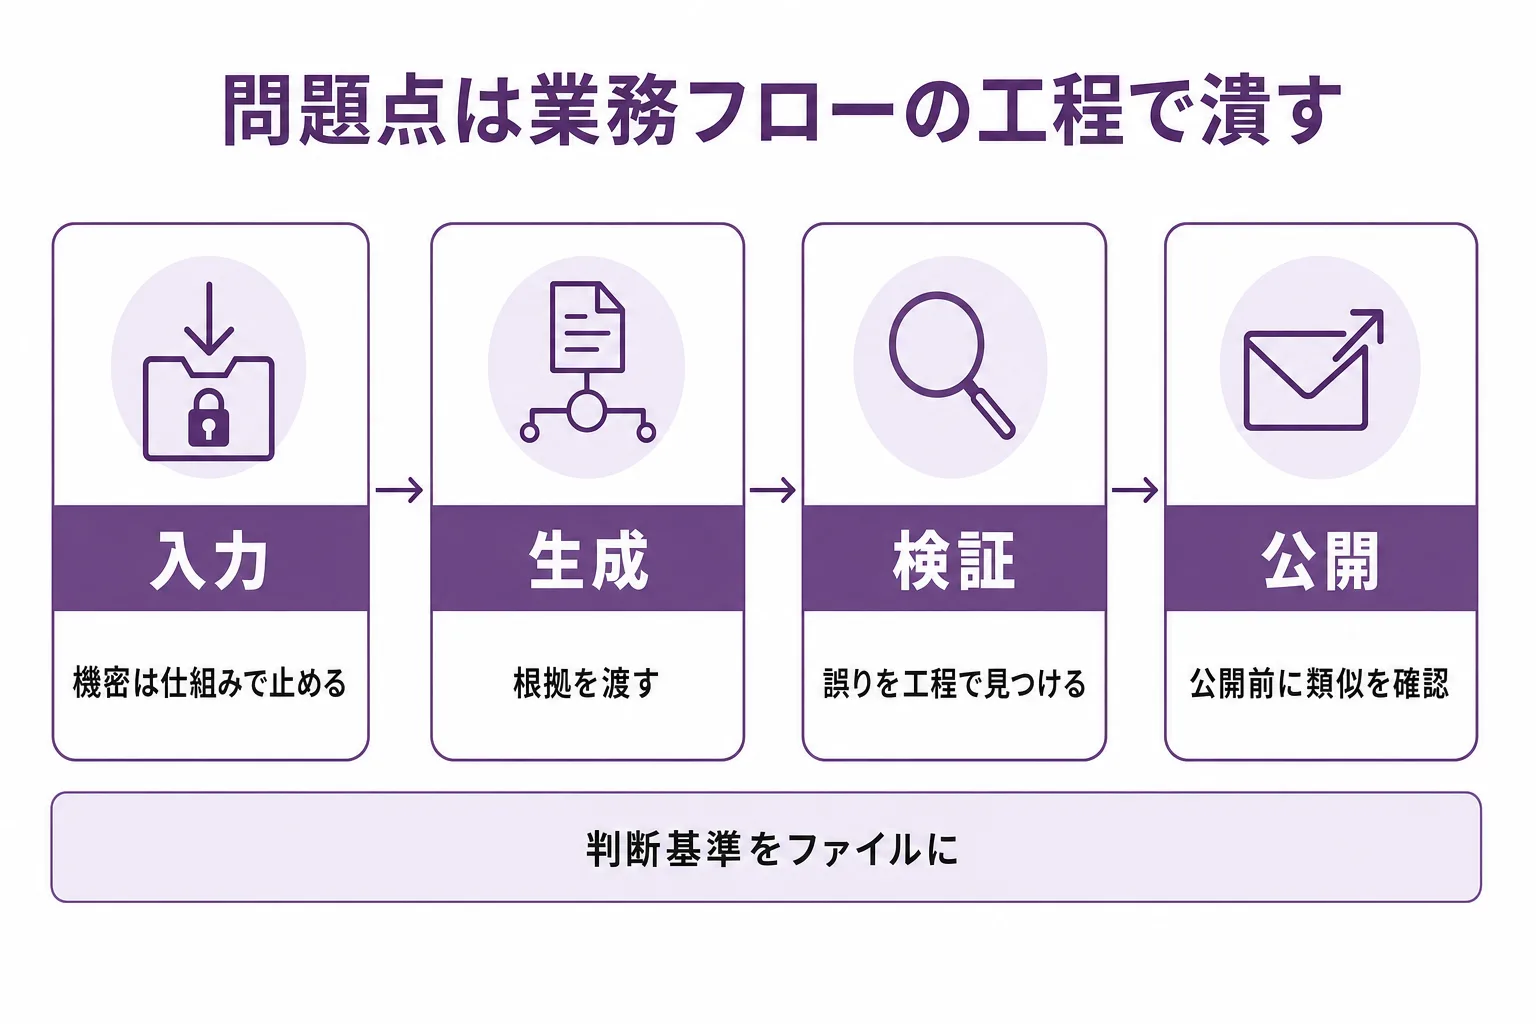
足りないのはルールの有無ではなく、審査と検証を工程として業務フローに埋め込むことです。本記事でいう審査は使うと決める前の可否判断、検証は出てきたものの確かめ(事実の裏取りと偏りの確認)と、続けたあとの振り返りの両方を指します。ガイドラインの整備で終わらせると、問題点は現場に残ります。この記事で挙げた対策を作業の順に並べると、次のようになります。
| 区切り | 決めること | 該当箇所 |
|---|---|---|
| 決める前 | どの業務でAIを使うか、任せる範囲とAIに許す操作の範囲を誰が判断するか | 6-2・7-2・7-6 |
| 使う前 | 会社として用意するサービスと契約、利用規約と起きたときの段取り、参照させるデータの範囲、効果を測る指標 | 3-1・3-3・4-1・5-2・6-1 |
| 入力する前 | 入れてよい情報の線引き(個人情報・機密情報) | 3-2・7-4 |
| 生成した直後 | 事実の裏取りと偏りの確認を誰がどの情報源で行うか、生成の経緯の記録 | 4章・5-2・7-3 |
| 成果物として使う前 | 既存の著作物と似ていないかの検索(社内資料も対象) | 5-1 |
| 使い続けるあいだ | 効果の振り返りと、次に広げる範囲、指示・判断基準の更新 | 6-1・6-3・6-4・7-5 |
技術側の問題を受け止めるのは「生成した直後」と「成果物として使う前」の2つで、ハルシネーションや偏り、既存の著作物との類似を出た後に見つけます。ほかの4つは運用側の歯止めです。成果の側は1つの区切りに収まらず、対象業務を選ぶ「決める前」から、指標を決める「使う前」、振り返る「使い続けるあいだ」までにまたがります。
この6つに担当者を書き込めば、業務フローになります。次に見るとおり、日本企業で薄いのは先頭の「決める前」と、最後の「使い続けるあいだ」です。以降では、埋め込むときにつまずきやすい箇所と、社内ルール・進め方の決め方を取り上げます。
ガイドラインを作っただけでは潰れない
日本企業のリスク対策は、中身がガイドラインの整備に寄っています。前掲の「懸念されるリスク及びリスク対策のための取組状況」(令和8年版 情報通信白書)では、日本は「全社的な指針やガイドラインを整備している」が41.1%で最多でした。ただし選択肢の中で最も多いという意味で、過半数ではありません。
ガイドラインの整備率そのものは、米国50.4%・中国40.3%・ドイツ39.6%で、日本と大きくは変わりません。差がついているのは、その先の工程です。同じ調査で、企画・導入段階の専門的な審査体制は日本26.1%(米国52.5%・中国59.0%・ドイツ38.1%)、導入後の定期的な評価・検証は日本29.1%(米国45.7%・中国51.9%・ドイツ42.2%)でした。
なお、白書のいう「評価・検証」は工程表の「使い続けるあいだ」にあたり、7-3で扱う成果物1本ごとの裏取り(「生成した直後」)とは粒度が違います。
規模別では、ガイドライン整備が大企業44.9%に対し中小企業29.1%にとどまります。「特に実施している施策はない・把握していない」は中小企業で24.1%です(複数回答)。中小企業の7割はガイドラインを持たず、「作っただけ」の段階にも来ていません。これから作る場合は、ガイドラインと同時に工程を決めてください。先にガイドラインだけ作ると、大企業と同じ場所で止まります。すでにある場合は1本増やすのではなく工程としての審査と検証を足します。
社内でよく挙がる研修とログの確認も、単独では同じ壁に当たります。研修は受けた時点の理解を配るだけで、次に作る成果物を誰が確認するかは決まりません。ログの確認は後から追う仕組みで、社外に出る前に止める働きはありません(5-2の生成の経緯の記録も、目的は侵害を疑われたときの説明です)。どれも工程に紐づけて初めて効きます。
決める前に、可否を何で判断するか
7-1で日本が薄かった「専門的な審査体制」は、専任の部署や委員会を置く形を指します。中小企業が同じ形を作る必要はありませんが、可否を審査する工程そのものは要ります。専任の担当も要りません。決めるのは「この業務に使ってよいか」だけです。材料は次の3つで済みます。
- 出力が社外に出るか(出るものは確認を厚くし、社内で完結するものは軽くする)
- 渡す情報に個人情報や機密情報が含まれるか(含む場合は3-2の線引きを先に確認する)
- 間違えたときに何が起きるか(やり直せる範囲か、取引先や利用者まで届くか)
任せる範囲を広げるときは、3つとも軽いほうに寄る業務から順に足していきます。社内向け案内文の下書き、公開済み資料の要約、社内あての定型メールのたたき台あたりが入りやすい候補になります。逆に、6-2で効果が出やすい類型として挙げた議事録は、社内で完結する作業に見えて、人事や取引条件が入ると2つ目と3つ目の重みが跳ね上がります。同じ「文章を作る」でも、中身で判定は変わります。
誰が可否を決めるかも、同じ場所で決めておきます。業務の担当者が3つの軸で判断し、迷ったものだけ一段上へ上げる形で足ります。迷う基準は「3つのうち2つ以上が重いほうに寄る業務は担当者だけで決めない」といった線引きです。経営者が自分で判断する規模の場合は、一段上がない代わりに時間を置きます。迷ったものはその場で決めず、翌日に持ち越してください。
ただし成果物がほぼ社外に出る職種では、業務単位で線を引くとすべてが一段上の判断待ちになります。その場合は「下書きまでか、構成案までか」とAIに任せる範囲の単位で引いてください。ここまでが可否の判断で、出てきたものをどう確かめるかは次に見ます。
検証を工程の中に固定する
検証は工程に組み込んで初めて残ります。注意力に任せると、忙しい日から抜け落ちます。
当社では、AI業務基盤としてAnthropic社のClaude Code(指示や判断基準をファイルとして持たせて動かすAIツール)を使い、記事制作を構成設計・執筆・ファクトチェック・可読性チェック・コンプラチェック・画像選定・品質スコアリング・公開の8工程に分けて回しています。
ファクトチェックの工程では一次情報に直接あたって照合し、裏が取れないものは「未確認」と明示して次へ渡します。書く工程と確認する工程は別々のAIに担当させ、最後は人が本文と検証結果の両方を読んで公開の可否を決めます。AIにAIを確認させて意味があるのかという疑問はもっともです。確認側には書いた側の文脈を渡さず、出典に当たる手順だけを渡しています。書いた本人が自分の文章を見直すと誤りを見落とすのと同じで、文脈を切ると照合に集中します。
自社に置き換えるときは、成果物ごとにどの確認を誰がどの順で行うかを決めてください。作った人とは別の人が確認する形がいちばん強く働きます。全部に人を割けない場合は社外に出るものだけ別の人を通し、それも難しい場合は時間を空けて自分で読み返します。確認が済まないと次へ進めない形にすると、検証は飛ばされません。
確認する人が何を見るかは、成果物の種類ごとに決めておくと短時間で済みます。AIが書いた文章に出やすい癖は、下記記事で解説していますので、あわせてご覧ください。
入力は注意喚起でなく設定で絞る
情報漏洩の対策は、注意喚起より実装に寄せるほど効きます。
当社では、未発表の商品名・型番・コードネームが外部サービスへ送信される前に、実行そのものを止める仕組み(フック)をClaude Code上で動かしています。
検索やキーワードツールへの問い合わせは第三者のログに残るため、秘匿語として登録した語が含まれる場合は、実行される前に処理を止めます。止まるのはAIが外部へ問い合わせる経路で、機密が一切外部に出ないことを保証するものではありません。社員がプロンプトに貼る操作も止まりません。それでも、注意喚起ではなく実装で線を引く形は自社の環境にも移せます。
貼れる先を会社が用意したサービスに限り、AIに参照させるデータの範囲を絞ること(3-3)は、設定で決まります。そのサービスで入力が学習に使われないかは、契約で決まります(3-1)。設定で決まらない3-2の項目だけを、入力前のチェック項目として工程に残します。
判断基準を書き出して共有する
出力のばらつきは、6-4で見た判断基準をファイルに書き出し、次の人が呼び出せる形にすると小さくなります。
当社では、判断基準をClaude Codeのルールファイル18本に書き出しています。
「この数字は必ず一次情報で確認する」「この表現は使わない」といった判断を、作業のたびにAIが読み込むファイルにしたものです。同じ考え方で、繰り返す作業の手順(スキル)を50本、自動で走る確認・記録の処理を14本ためています(2026年9月時点)。
始めるのに専用の仕組みは要りません。書き出して共有するだけであれば、共有ドライブのドキュメント1枚でも足ります。AIに読ませる段になっても、同じファイルを指示のたびに渡せば足ります。大事なのは置き場所で、使った人がその場で追記できる場所を選んでください。更新されないドキュメントは、置いた時点から古くなります。
社内ルールと、任せてよい範囲の決め方
社内ルールをゼロから考える必要はありません。総務省と経済産業省の「AI事業者ガイドライン」が指針の下敷きになります。1章で触れた第1.0版から更新が重ねられ、現行は第1.2版(2026年3月31日公表)です。なお2025年9月1日に全面施行されたAI法は推進を定めた法律で、使う企業に禁止事項や罰則を課すものではありません。守るべき線は、これまでどおり個人情報保護法や著作権法とガイドラインで確認します。
第1.2版ではAIエージェント(人が都度指示しなくても、渡された目的に沿って自分で手順を選んで動くAI)の定義が加わり、留意事項に「人間の判断を介在させる仕組みの構築や最小権限設定」が明記されました。ここでいう権限は、3-3の社員のデータ閲覧権限ではなくAIにどの操作まで行わせるかの範囲です。下書きを作らせるだけの段では考える必要がありませんが、社内システムへの登録や送信まで任せる段では分かれ目になります。任せる範囲を広げてよいかは、7-2の3つの判断軸と、この操作の範囲を決められたかで判断できます。
参考AI事業者ガイドラインの令和7年度更新内容(説明資料)|総務省・経済産業省(令和8年3月12日)ここまでの決め方が固まったら、次は対象業務を広げる段になります。導入のステップと使える補助金は、下記記事で解説していますので、あわせてご覧ください。
自社に合った進め方を選ぶ
ここまでの工程は、専用の仕組みがなくても社内で組み上げられます。外部の力が要るのは、決めた工程を回し続ける段で詰まったときで、詰まる場所によって進め方は3つに分かれます。
| 比べる軸 | 社内で回せるようにする | 基盤ごと任せる | 実務ごと任せる |
|---|---|---|---|
| 詰まる場所 | 回してみたが自社に合う形にならない | 手作業の運用では追いつかなくなった | 回す時間が取れない |
| 手元に残るもの | 運用できる人 | 自社仕様の業務基盤 | 本業に使える時間 |
表の左から順に、当社の内製化支援(自社の業務を教材にOJT形式で伴走)、AI業務基盤構築(検証工程の設計からナレッジ管理まで)、実行支援(記事や資料の制作と運用ごと)が受け皿になります。制作ごと任せる場合も、公開の可否だけは自社に残す形にしてください。
まとめ:生成AIの問題点は工程に落として潰す
生成AIの問題点は、ハルシネーションやバイアスのように技術から生まれるものと、機密情報の入力や検証の欠落のように運用から生まれるものに分かれます。前者は確認する工程を置いて見つけ、後者はルールと権限設計を工程に紐づけて減らします。成果の側の課題(効果を説明できない、効く業務が偏る、社内に広がらない、出力がばらつく)は、対象業務と測り方を先に決め、1つの業務で型を作ってから広げ、うまくいった判断基準をファイルに残すと縮みます。
日本企業の生成AI利用は86.4%に達し、使い始めた企業の論点は導入の可否から使いこなしへ移りました。ただし効果を評価できていない企業は残り、対策はガイドライン整備に偏って審査と検証の工程が薄いままです。
最初にやることは、7章に挙げた6つの区切りに、決めることと担当者を書き込む作業です。とくに埋めておきたいのは、どの業務でどこまで任せるか・誰が何を確かめるか・効果を何で測るかの3つです。この3つが埋まれば、次に手を入れる場所が自分で見えます。上司や役員に説明するときも、埋めた表がそのまま材料になります。ガイドラインを1本増やすより、この作業のほうが問題点は早く減ります。
参考文献
- 生成AIが抱える課題|総務省 令和6年版 情報通信白書
- 生成AIの業務利用状況|総務省 令和8年版 情報通信白書
- 組織的な取組状況|総務省 令和8年版 情報通信白書
- 懸念されるリスク及びリスク対策のための取組状況|総務省 令和8年版 情報通信白書
- AI導入・活用を効果的に進めていくために重要となる要素|総務省 令和8年版 情報通信白書
- AI導入・活用による効果創出のステップ|総務省 令和8年版 情報通信白書
- 「情報セキュリティ10大脅威 2026」を決定|IPA(2026年1月29日)
- 情報セキュリティ10大脅威 2026|IPA
- 生成AIサービスの利用に関する注意喚起等|個人情報保護委員会(令和5年6月2日)
- Microsoft Copilot のデータ、プライバシー、セキュリティ|Microsoft Learn
- AIと著作権に関するチェックリスト&ガイダンス|文化庁著作権課(令和6年7月31日)
- AIと著作権に関する考え方について|文化審議会著作権分科会法制度小委員会(令和6年3月15日)
- 生成AIに関する実態調査2026 春 6カ国比較|PwC Japanグループ
- 中小企業のAI等の利活用に係る実態調査(2026年3月)|中小企業基盤整備機構
- AI事業者ガイドライン(第1.2版)|総務省・経済産業省(令和8年3月31日)
- AI事業者ガイドラインの令和7年度更新内容(説明資料)|総務省・経済産業省(令和8年3月12日)
- 人工知能関連技術の研究開発及び活用の推進に関する法律(AI法)|内閣府